POG指名馬検討用のスキル
ダービーまであと3週間、、ということでPOG指名馬検討用のClaude Codeスキルを作ってみました。
できること
2種類のスキルを作りました。
どちらも、対象馬の基本情報とnetkeibaの掲示板コメントからレポートを作成します。
/pog-horse-report {馬名}
今年度の2歳馬を対象にポジティブな評価、ネガティブな評価をまとめたレポートを作成します。 掲示板からも情報を収集するので赤本、青本発売以降の最新情報も反映できるのではないかと期待。
/pog-bitter-lesson {馬名}
前年度、期待してたほど活躍しなかった馬を対象にどこにサインがあったかを振り返り、教訓として今年度に活かすためのレポートです。
出力レポートのサンプル
/pog-horse-report ラッキースパークル
======================================================
  POG馬レポート:ラッキースパークル
  作成日:2026年5月7日
======================================================

【基本情報】
馬名  :ラッキースパークル(Lucky Sparkle)
性別  :牡馬
生年月日:2024年2月19日
馬体重 :477kg(赤本記載)
父   :エピファネイア
母   :ラッキーライラック(2015105046)
母父  :オルフェーヴル
調教師 :松永幹夫(栗東)
馬主  :サンデーレーシング
生産者 :ノーザンファーム
募集価格:1口300万円 × 40口
戦績  :0戦0勝 [0-0-0-0]

【母の繁殖成績】
・ラッキーライラックの2022:0戦0勝(未出走または引退)
・ラッキーライラックの2024:ラッキースパークル(本馬)
・ラッキーライラックの2025:募集予定馬として確認
※ 初仔(2022年産)の戦績は現時点でなし。繁殖実績としてはサンプル不足の段階。

------------------------------------------------------
【近況(時系列)】
------------------------------------------------------
2024年12月:掲示板にラッキーライラックの子として初コメント
2025年 1月:牧場内での評判が高いとの情報が入る
2025年 4月:サンデーサラブレッドクラブの2025年度募集予定馬に掲載
2025年 6月:現地見学者が「父エピファネイアの生き写し」「牧場内でオーラが違う」と評価
             動画公開。グイグイ歩く前向きさと馬体バランスの良さが確認される
2025年 7月:一口クラブの出資受付開始・出資確定。高倍率で人気馬であることが判明
2026年 3月 7日:馬名「ラッキースパークル」(幸運なきらめき)発表
2026年 4月 3日:しがらきに向けて天栄に移動
2026年 4月17日:松永幹夫厩舎(栗東)に入厩。関係者コメント「ここまで順調に来ており喜ばしい限りです」
2026年 4月23日:ゲート試験合格
2026年 4月24日:母ラッキーライラックを担当した丸内助手が本馬も担当。目元がライラックに似ているとのこと
2026年 5月現在:デビュー待ち。夏の小倉・新潟でのデビューが予想される

------------------------------------------------------
【ポジティブな評価】
------------------------------------------------------
■ 父エピファネイア(POG最優先種牡馬)
・2歳リーディング上位常連。早期始動とクラシック適性の両立という点でPOG向き最高評価の種牡馬。
・本馬の馬体が父の生き写しとの評価が複数の見学者から寄せられており、父の良い形質を引き継いでいる可能性が高い。

■ 馬体・歩様の優秀さ
・動画を見た複数のコメント者が「馬体バランスが本当に素晴らしい」「馬体も歩様もエグすぎる」と評価。
・「グイグイ歩いていく感じで前向きさもありそう」という前向きな気性を示す動作が確認されている。
・馬体重477kgは大型馬であり、成長余地を残しつつ競走馬としての迫力がある。

■ 早期始動(POGのSランク項目)
・2026年4月17日入厩、同月23日にゲート試験合格という非常に速い仕上がりペース。
・夏(6〜8月)の小倉・新潟デビューが現実的であり、POGポイント積み上げ期間が長く取れる。

■ 外厩・生産体制が万全
・ノーザンファーム生産+天栄・しがらき経由という「黄金ルート」で仕上がっており、デビュー前の環境面は最高峰。

■ 馬主:サンデーレーシング(POG最優先馬主)
・ノーザンファームの中核クラブ。良血×トップ厩舎×外厩の黄金ルートが完備されており、POG最優先評価。

■ 配合の成功事例
・エピファネイア×オルフェーヴル系の配合では、同系統のオーソリティ(エピファネイア×オルフェーヴル産駒の牝馬経由)が活躍した事例がある。
・コメントでも「血統的相性から見ても期待できる」との指摘あり。

■ 牧場内での評価
・「牧場内でも他厩舎の方が噂している」「一頭だけオーラが違う」という牧場関係者・他厩舎スタッフからの評価が複数確認されており、玄人目線での評価が高い。

■ 母と同担当
・ラッキーライラックを担当した丸内助手が本馬も担当。母の気質・特性を熟知したスタッフが育成に当たっており、個体への対応力が高い。

------------------------------------------------------
【ポジティブな評価に含まれる潜在的リスク(期待先行コメント)】
------------------------------------------------------
・「未来のダービー予約します」「来年のクラシックの中心は間違いなくこの子」
  → デビュー前の誇張表現。実際のパフォーマンスは未知数。

・「ドバイのどれか勝ってもおかしくない」「300万が安く感じる」
  → 出資バイアスが強くかかっているコメント。実力の裏付けなし。

・「化物を産んだかもしれない」
  → 動画・牧場評価に基づく期待先行コメント。実戦での確認は不要。

・「牧場内でオーラが違う」(コメントNo.19)
  → 牧場見学という非公式な情報源。有力馬が高評価を受けやすいバイアスがある。

・「幹夫の最高傑作になるでしょう」
  → 実績のない根拠なき期待コメント。

------------------------------------------------------
【ネガティブ・懸念点】
------------------------------------------------------
■ 母父オルフェーヴルはPOG慎重評価
・bms.md評価:「慎重 - 晩成・スタミナ型でPOG期間に間に合いにくい。爆発力あるがムラが大きくリスク高い」
・nix.mdのランキングにエピファネイア×オルフェーヴルの組み合わせは掲載なし(エピファ×ディープがS、エピファ×キンカメがA+)。
・POG黄金配合からは外れており、配合の再現性という観点では一段評価を落とすべき組み合わせ。

■ 気性リスク(POGのSランク項目)
・エピファネイア(気性難産駒が散見される)×オルフェーヴル(ムラが大きく気性難で知られる)の掛け合わせ。
・コメントNo.38で「父と母父の血でとんでもない暴れ馬にならない事を祈ります」という気性懸念が明確に指摘されている。
・早熟×晩成の血統の掛け合わせによる気質の不安定性も考慮が必要(コメントNo.64)。

■ 調教師・松永幹夫のPOG評価が不明確
・POG向き厩舎リストに松永幹夫は掲載なし(最優先・上位・中上位のいずれにも未掲載)。
・ラッキーライラックの管理実績は申し分ないが、2歳戦の早期仕上げ・積極的なローテーション組みがPOG向きかは評価不明。
・種牡馬×厩舎のランキングにも「エピファネイア×松永幹夫」の組み合わせは未掲載。

■ クラブ馬としての使い分けリスク(POGのAランク項目)
・サンデーレーシングは最優先馬主だが、同世代に有力馬が密集する大手クラブの宿命として、使い分けリスクがある。
・本馬が2026年のクラシック路線の本命格になる場合、出走機会をセーブされる可能性もある。

■ 母の繁殖実績が乏しい
・初仔ラッキーライラックの2022は現時点で0戦0勝(出走なし)。
・母の繁殖能力について実績が十分でなく、産駒の競走能力の再現性はまだ判断できない段階。
・ただし、ラッキーライラック自身はGI6勝の超一流繁殖牝馬であり、繁殖牝馬としてのポテンシャルは高い。

■ 個人評価でのCランク(コメントNo.18)
・「2、3勝クラス止まり。価格に見合わない。C」という辛口評価が1件存在する(個人見解)。
・価格(総額1億2000万円)に対し、能力が伴わない可能性を指摘した評価。

------------------------------------------------------
【総評】
------------------------------------------------------
ラッキースパークルは、POG最優先種牡馬エピファネイアの産駒かつGI6勝馬ラッキーライラックの初仔(2番仔)という、血統面で非常に注目度の高い1頭。

POG的な最大の強みは「早期始動」と「サンデー×ノーザン体制」。2026年4月入厩・同月ゲート合格という仕上がりの速さは、夏デビューへの現実的な期待を裏付けており、POGポイント取得機会の最大化という点で高評価。馬体・歩様の動画評価も高く、牧場内での評判も良好。

一方で最大の懸念は「母父オルフェーヴルによるPOG的ロス」と「気性リスク」の二点。エピファ×オルフェという配合はランキング上位の黄金配合に入っておらず、オルフェ系の晩成・ムラ・気性難のリスクがPOG期間(主に2歳〜3歳5月)に顕在化する可能性がある。また、調教師・松永幹夫の早期仕上げ実績が不透明という点も、上位厩舎と比較した場合の不安材料。

総合評価としては「高ポテンシャル・中〜高リスク」のプレミアム指名候補。

・ドラフト上位(1〜2巡目)での指名価値:あり
・ただし気性・厩舎ローテが2歳戦成績を大きく左右するため、デビュー後の調教内容・レース選択を確認してから追加評価を行うことが推奨される。
・「エピファネイア×木村哲也」「エピファネイア×宮田敬介」のような黄金コンビには及ばないが、血統と早期始動実績の組み合わせで指名順位は十分上位に入る。

【POGチェックリスト評価サマリー】
 Sランク:早期始動 …… ◎(4月入厩・ゲート合格、夏デビュー想定)
 Sランク:厩舎傾向 …… △(松永幹夫:評価不明確)
 Sランク:気性   …… △(エピファ×オルフェの気性リスクあり)
 Aランク:血統再現性 …… △(エピファ×オルフェは黄金配合外)
 Aランク:ローテ自由度 … △(大手クラブ馬のため使い分けリスク)
 Aランク:調教内容 …… ─(未デビューのため未確認)
 Bランク:馬体   …… ◎(477kg、バランス・歩様評価が高い)
 Bランク:騎手リソース … ─(未確定)
 Cランク:市場評価 …… ◎(高倍率人気馬、牧場内評価も高い)

======================================================
/pog-bitter-lesson コニーアイランド
■ コニーアイランド POGポストモーテムレポート(2026年5月8日作成)
  ※分析対象期間:2025年5月末まで(馬ID先頭4桁2023+2)

━━━━━━━━━━━━━━━━━━━━
【基本情報】
━━━━━━━━━━━━━━━━━━━━
馬名   :コニーアイランド
性別   :牝
生年月日 :2023年2月16日
父    :コントレイル
母    :ヤンキーローズ
母父   :All American
調教師  :中内田充(栗東)
馬主   :サンデーレーシング
生産牧場 :ノーザンファーム
一口価格 :250万円/40口
戦績   :3戦1勝 [1-0-0-2]
賞金   :920万円
勝ち鞍  :25'2歳新馬
近親   :リバティアイランド(G1複数勝・牝馬三冠)、ロムネヤ

【評価】
「コントレイル×ヤンキーローズ×中内田×サンデーレーシング×ノーザンファーム」という
最強陣営でありながら、2歳新馬を1勝したのみで重賞路線に乗れず。
「リバティアイランドの妹」として高い注目を集めたが、期待に応えられなかった。

━━━━━━━━━━━━━━━━━━━━
【分析期間内のポジティブな客観的コメント】
━━━━━━━━━━━━━━━━━━━━

① 馬体サイズは良好(2024年6月〜7月)
  「445kgあり、リバティの同時期よりも体格あるらしい」(2024/6/7)
  「7月3日現在の馬体重465kg(6月から25kg増)」(2024/7/16)
  → 馬体重は順調に増加。リバティより大型で体格は申し分なし。

② 気性が安定(2025年4月)
  「気性的には姉たちと比べて一番やりやすいです」(中内田調教師、2025/4/23)
  「半姉のマディソンガールは気持ちが難しいタイプですが、こちらは今のところ大丈夫そうです」(2025/4/9)
  → 母系の気性難を受け継がず、折り合い面は良好。

③ 早期入厩・ゲート合格(2025年4月)
  栗東TC入厩(2025/4/4)
  ゲート試験合格(2025/4/23)
  「6月開幕週デビューも視野」(2025/2/27)
  → 早期始動の条件を満たし、夏デビューが現実的な状況。

④ 調教が一時的に順調
  「屋内坂路コースをハロン14〜15秒で2本登坂」(2025/3/27)
  「週3日は坂路コース(800m)をハロン17秒で1本登坂」(2025/5/23)
  → 3月時点の坂路時計は一定水準にあった。

━━━━━━━━━━━━━━━━━━━━
【不安要素・ネガティブな客観的コメント(後から見れば「サイン」だったもの)】
━━━━━━━━━━━━━━━━━━━━

⚠️ サイン①:「トモの感じはリバティの方が上」(2024/6/22)
  コメント:「手先が軽く腹回りがドッシリしてるのは好感。トモの感じはリバティの方が上」
  → リファレンス「トモで8割決まる」の原則に照らすと、リバティより劣ると評された時点で
    最高評価からは外れる。「手先が軽い」も見た目の良さであり、推進力の源泉ではない。
    この1文を2024年6月の時点で正確に受け取れていたかが全て。

⚠️ サイン②:「オークスというよりは桜花賞が目標。2000mはなんとか」(2024/6/9)
  コメント(ツアー情報):「姉よりは胴がやや短く筋肉量が多いので、
    オークスというよりは桜花賞が目標。2000mはなんとか。」
  → 「胴がやや短い」という体型的な特性は距離適性の制限に直結する。
    クラシック路線での活躍幅が1600〜2000m止まりと早期から示唆されていた。
    POGでの賞金加算機会を自ら狭めていたことを示す。

⚠️ サイン③:コントレイル産駒の体質リスクへの言及(2025/4/28)
  コメント:「父コントレイル自身が体質強い方ではないからね」
  → コントレイルは現役時から体質が繊細と評されてきた種牡馬。
    産駒にその体質面が受け継がれるリスクへの言及は、
    無事に使い続けられるかという根本的な懸念を示している。

⚠️ サイン④:「少し馬体がしぼんでいたので戻しているところ」(2025/5/9)
  コメント:「少し馬体がしぼんでいたので戻しているところです。現在の馬体重は470kg」
  → 入厩・ゲート合格・放牧と続く一連の過程で馬体が絞れていた。
    大型馬が一時的に体重を落としたことは、消耗・体質の繊細さを示す可能性がある。

⚠️ サイン⑤:「馬体が回復しているので〜」(2025/5/23)
  コメント:「馬体が回復しているので、運動量を確保したメニューに取り組んでいます」
  → 「回復している」という表現は、直前に何らかのコンディション低下があったことを示す。
    デビュー前の時期に馬体回復を優先している状況は、出走時の万全な状態を疑わせる。

⚠️ サイン⑥:「ノード野郎がいる」という書き込み(2025/5/31)
  コメント:「ここにもノド野郎がいるんだな」
  → 「ノド」はいわゆる「喉鳴り(ロアリング)」を指す可能性が高い。
    喉鳴りは激しい運動時の呼吸を妨げ、パフォーマンスに直接影響する深刻な問題。
    この書き込みが何に反応したものかは不明だが、2025年5月末時点で
    既にノドの問題を示唆するコメントへの反応があったことは見逃せない。

⚠️ サイン⑦:入厩翌日に即放牧(2025/4/23→4/25)
  ゲート試験合格(4/23)の翌々日(4/25)にNFしがらきへ放牧。
  → これほど早いタイミングでの放牧は、「ゲート合格を一区切りに一度緩める」という
    体質への配慮の可能性がある。通常のデビュー前の馬では入厩後継続的に乗り込むケースが多い。

⚠️ サイン⑧:「体力はありそうな雰囲気」という曖昧な調教師コメント(2025/4/9)
  コメント:「体力はありそうな雰囲気です」(中内田調教師)
  → リファレンスの「具体性のないコメントはグレー」の法則通り。
    「体力が確認できている」ではなく「ありそうな雰囲気」という言い回しは
    調教師自身が断言できない状態を示している。

━━━━━━━━━━━━━━━━━━━━
【総合分析:隠れていた不安のサイン】
━━━━━━━━━━━━━━━━━━━━

コニーアイランドの失速を事後的に読み解くと、3つの層に分けられるサインが存在した。

【第1層:血統・馬体から読み取れたサイン(2024年6〜7月)】
  最も早期から存在した構造的な問題。
  「トモはリバティより劣る」は馬体評価の最重要指標への警告。
  「胴がやや短く」から来る距離適性の制限は、クラシック路線での活躍幅の狭さを示唆。
  この時点でリバティアイランドとの能力差は構造として現れていた。

  さらに、父コントレイルはPOGリファレンスで「上位候補」に位置づけられているが、
  産駒の体質面リスクは既に市場で認識されていた(種牡馬自身の体質問題から)。

【第2層:陣営・環境要因(2025年3〜4月)】
  入厩後の即放牧、「体力はありそうな雰囲気」という調教師の曖昧な表現、
  これらはコンディション管理に慎重さを要する馬であることを示していた。
  中内田厩舎はPOG最優先厩舎だが、馬自身の体質が良い厩舎の力を活かせるかは別問題。

【第3層:デビュー直前の馬体管理問題(2025年5月)】
  「馬体がしぼんだ→回復中」という経緯は、
  デビューに向けた最終調整局面でのコンディション不安定を示していた。
  加えて「ノド野郎」への言及は、喉鳴り問題がすでにファンの間で認識されていた可能性を示す。

【過大評価の構造】
  「リバティアイランドの妹」という期待バイアスが全てを覆い隠した。
  一口250万円は第一希望で101票が殺到し、落選者が続出するほどの人気。
  掲示板コメントの大半が「リバティ」「川田」「姉」という文脈での期待。
  このバイアスが「トモはリバティより劣る」「胴がやや短い」という
  静かな警告の声をかき消した。

━━━━━━━━━━━━━━━━━━━━
【結論:今後のPOG指名への学び】
━━━━━━━━━━━━━━━━━━━━

① 「名馬の兄弟・姉妹」バイアスに注意する
  同じ母から生まれても父が違えば別の馬。
  「リバティの妹」という情報が入った瞬間に批判的思考をやめることが危険。
  むしろ「この馬自身のトモはどうか」「胴の長さはどうか」を冷静に評価すべき。

② トモの評価は絶対に妥協しない
  「トモはリバティの方が上」という一言が全ての答えだった。
  POGにおいてトモの評価は最優先指標であり、どれだけ陣営が良くても
  この指標が劣れば能力の天井が低い可能性を常に念頭に置く。

③ 調教師コメントの曖昧さに敏感になる
  「体力はありそうな雰囲気」「体力が戻っているので」といった
  断定を避けた表現や回復を前提とした表現は、
  能力への自信ではなくコンディション管理の苦労を示すサイン。

④ 入厩→即放牧のパターンに要注意
  ゲート合格直後の放牧は体質への配慮を示す可能性がある。
  「順調に進んでいる」という情報の裏に、ギリギリの体質管理が隠れていることがある。

⑤ 「ノド」への言及は見逃さない
  喉鳴りの問題はパフォーマンスに直接影響し、POG期間の活躍を大きく制限する。
  わずかな言及でも「ノド」関連のコメントは重要な情報として記録すべき。
まだプロトといったところで改善の余地が色々とある段階ですがPOG指名馬検討で少しでもラクしたい方は使ってみてください
POGドラフト指名馬入力ツールのリメイク
過去にPOGドラフトでの指名馬入力ツールを作りましたがこの度リメイクしました。
<過去の記事> sanshonoki.hatenablog.com
背景
理由としてはVue.jsが2.xで古く、Node.jsのバージョンを上げるためにはVue 3.xに移行しなければならなかったためです。 Vue 3.x にあげるためには大幅な改修が必要だけど、Vueの知識は完全に忘れてしまっている.. ちゃんとマイグレーションするためにテストコードを書こうにもNode.jsのバージョンを上げないとテストフレームワークがインストールできない.. というデッドロック状態でした。
ちょうどClaude Codeを使い始めたところでこれはバイブコーディングの良いお題となるなと思い、リメイクすることにしました。
コード
開発したソフトウェアはこちらです。興味のある方は使ってみてください。 機能面は旧バージョンと同じです
新旧フレームワークの違い
| 旧バージョン | 新バージョン | |
|---|---|---|
| フレームワーク | Vue.js | Next.js |
| データベース | Firebase | Supabase |
モダンWeb開発のスタンダードだと思われる Next.js x Supabase を採用しました
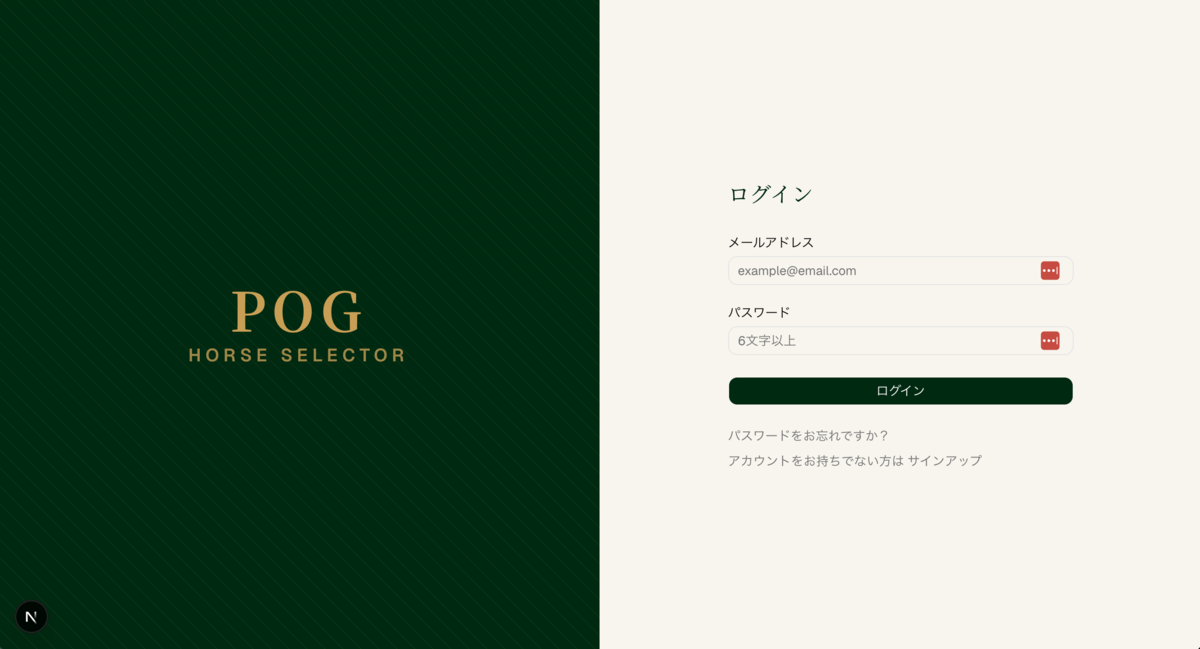
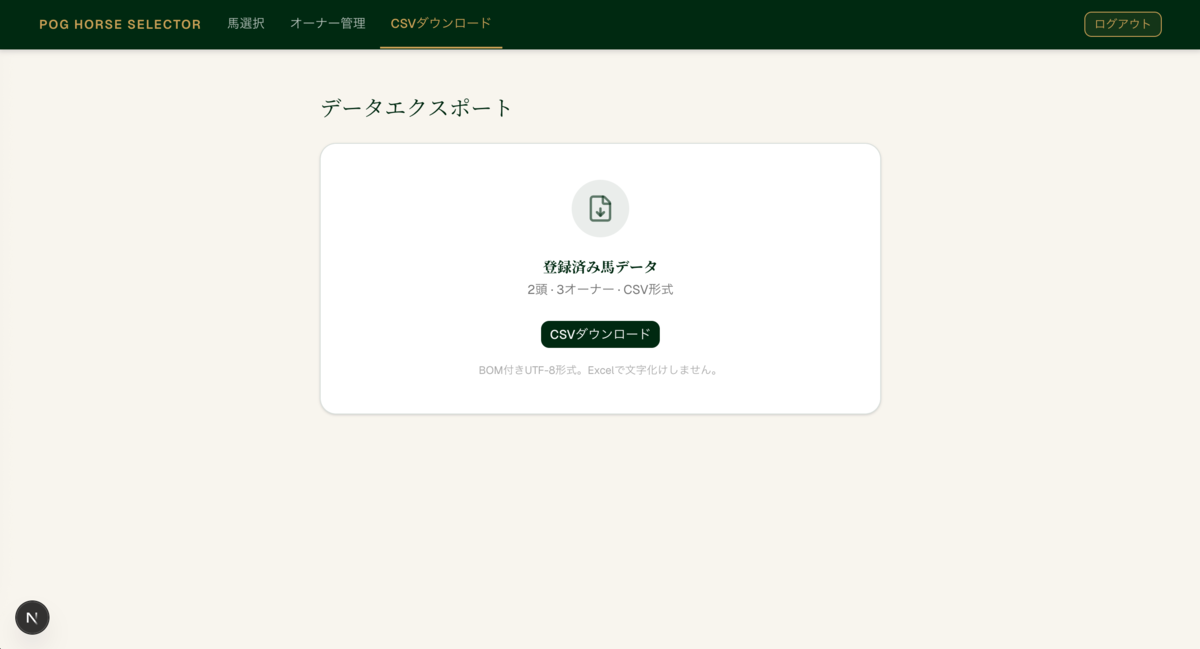
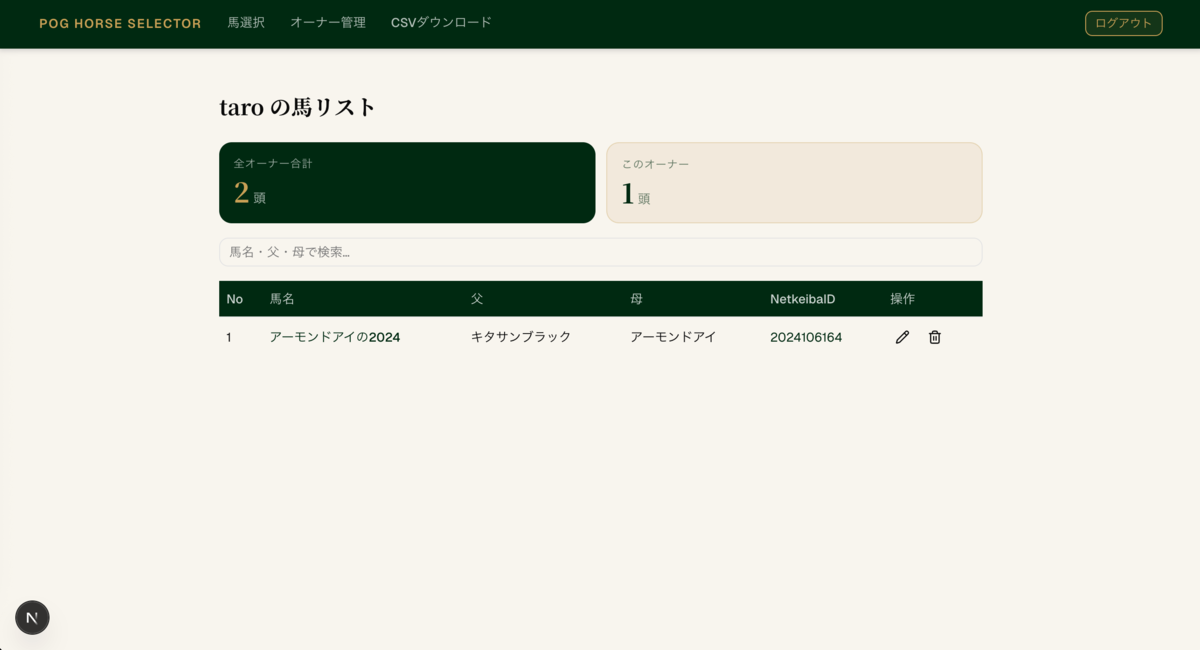
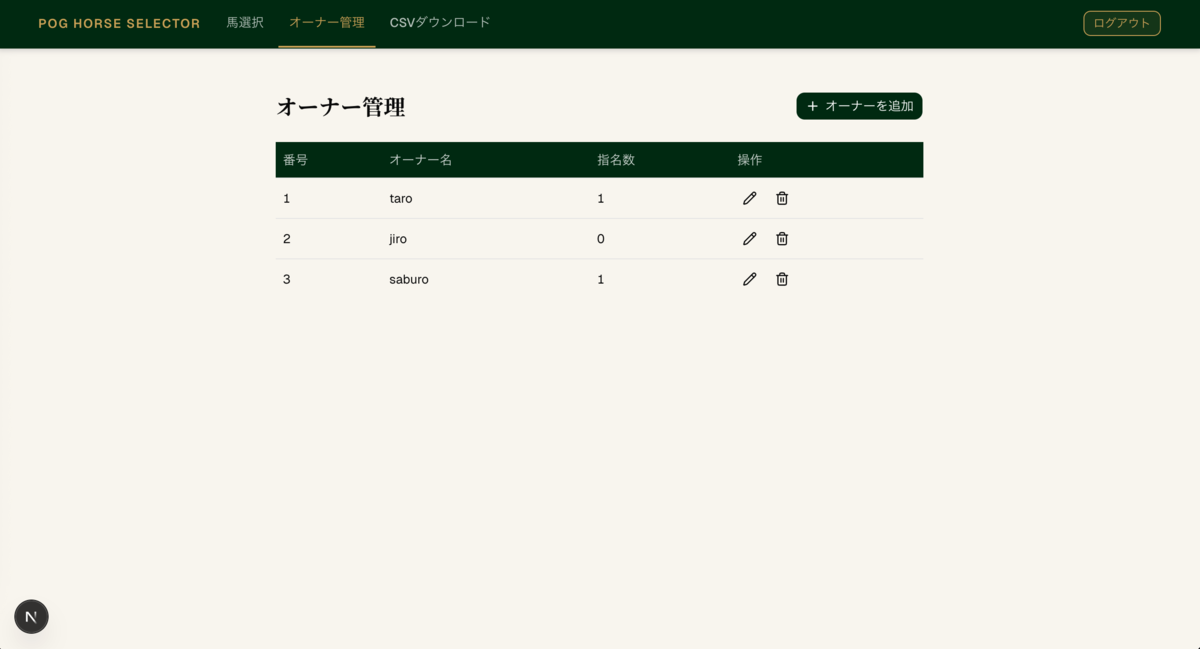
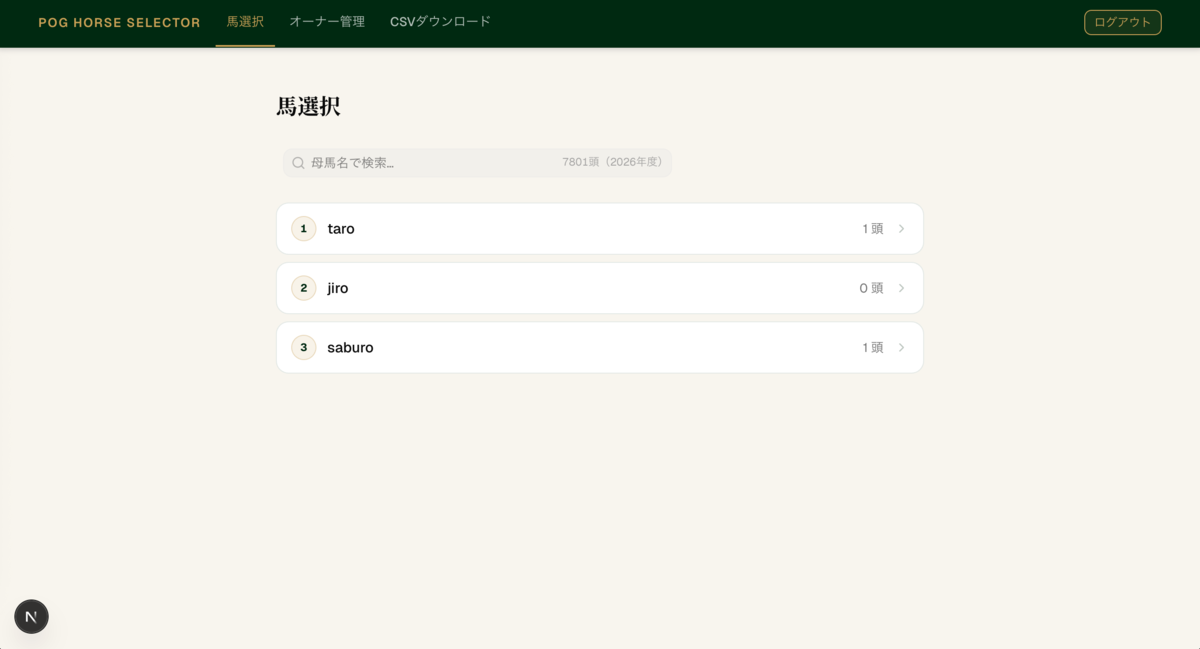
画面イメージ
ログイン画面
馬選択画面
馬リスト画面
オーナー管理画面
CSVエクスポート画面
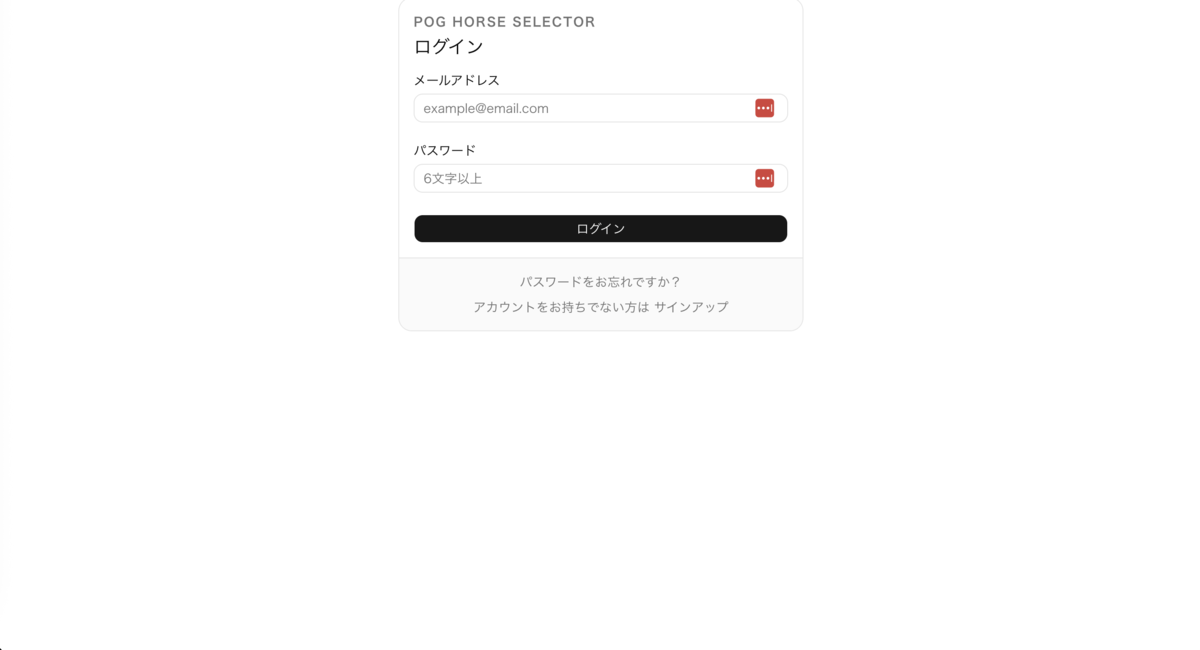
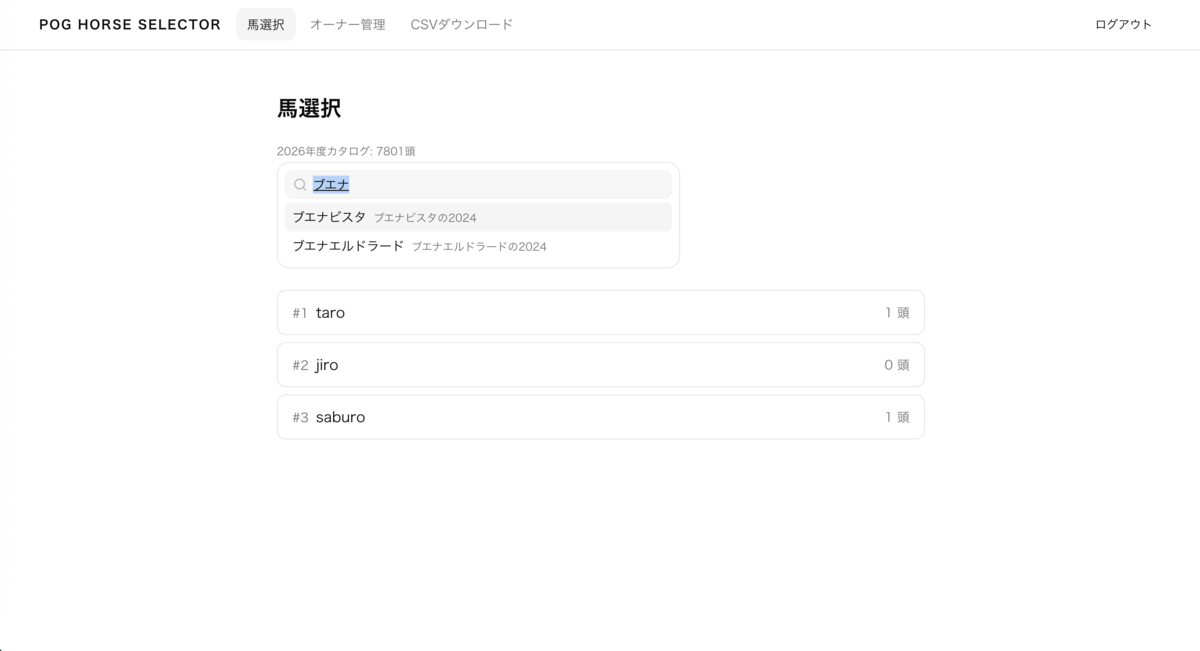
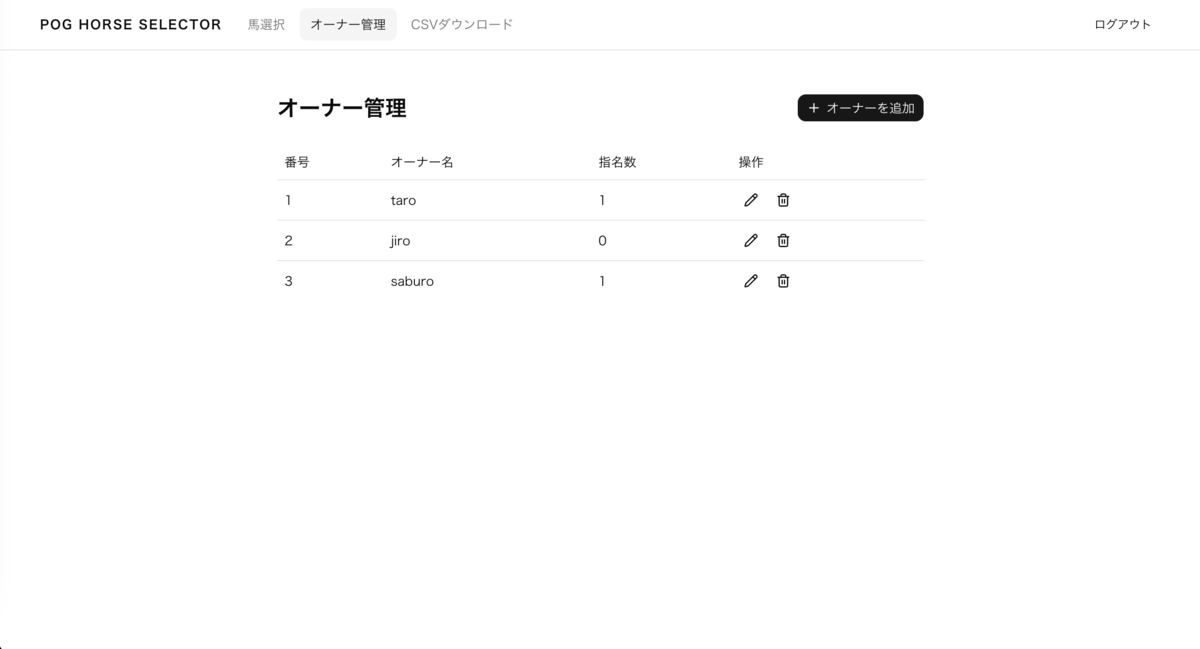
参考:frontend-designスキル投入前の画面
お試しとしてfrontend-designスキルを使ってUI品質改善してもらいましたが改善前の画面はこんな感じでした
ログイン画面
馬選択画面
オーナー管理画面
CSVエクスポート画面
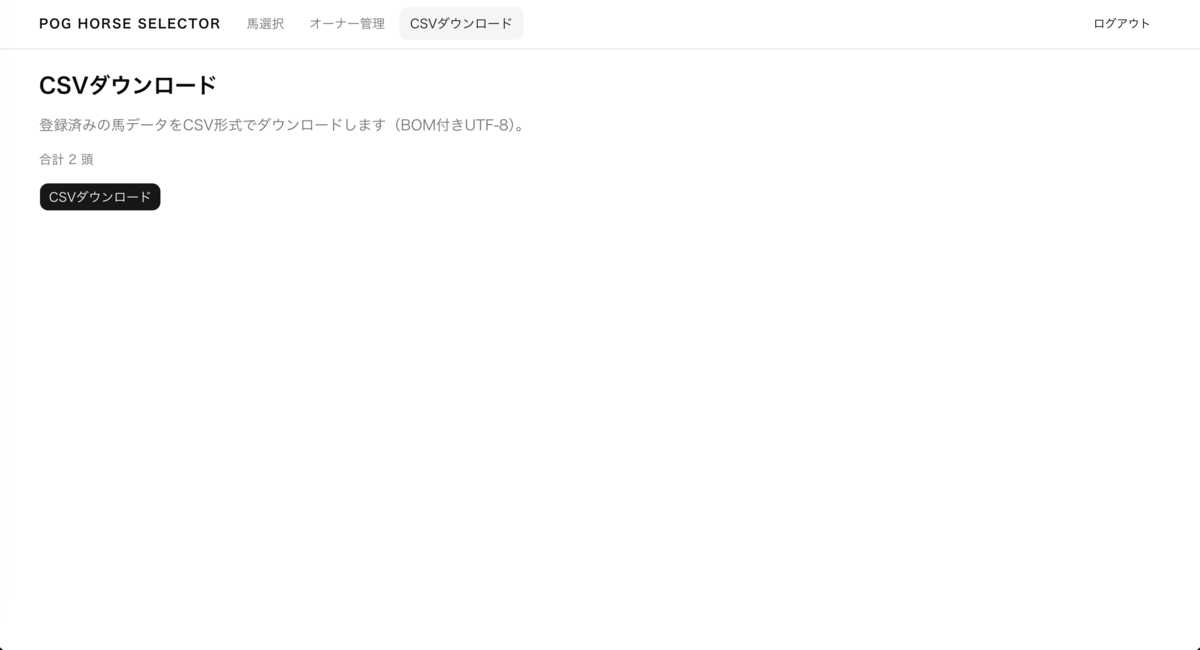
個人的にはこれはこれでシンプルで好きですが。。
参考記事
- 【2026年4月更新】Claude Codeの役に立つフロントデザインのskills10選 #AI - Qiita
- Claude Code公式プラグイン「frontend-design」完全解説 - AIの"AIスロップ"問題を解決する革新的スキル|アイドリ | AI-Driven Lab
開発の進め方
最初に元バージョンのリポジトリ上でコードの内容からSpec.mdとPLAN.mdを作ってもらい、PLAN.mdに基づいて骨組みを実装。 その後はローカル管理のIssueリストでIssueを登録→実装をひたすら繰り返しました。
導入したスキル
最初に Karpathy Guidelinesのスキル を導入
その後、Skills.sh から以下の4つのスキルを導入
- vercel-react-best-practices
- supabase-postgres-best-practices
- frontend-design
- web-design-guidelines
導入したサブエージェント
Awesome Claude Code Subagentsから3つのサブエージェントをインストール
- voltagent-core-dev@voltagent-subagents
- voltagent-lang@voltagent-subagents
- voltagent-qa-sec@voltagent-subagents
Karpthy Guidelinesのスキルが強く以下の自作のスキルコマンドで十分スムーズに開発を進められましたが
---
name: implement-issue
description: 機能実装やバグ・不具合の修正対応を行うときに使用するスキル
---

- 実装を開始する前にKarpathy Guidelinesを確認してください
- バグ・不具合の場合は、問題の本質的な原因を分析・把握し、対応策の計画を立ててください
- 適切なサブエージェントを使って実装してください
- 実装が完了したら、関連するテストコードを修正もしくは新規作成し、全テストが通ることを確認してください
- レビュー用のサブエージェントで厳しくレビューしてください
- レビュー結果の深刻度がCritical, High, Mediumの指摘には必ず対応し、修正する
- コミット前のチェックを行い、全テストがすべて通ったらコミットし、報告する
今なら Superpowersを使って開発を進める気がします。
感想
Claude Codeの使い方を学びながら、色々試しながらかつProプランだとすぐトークン切れになるので3週間程度かかりましたが 熟練したユーザーでMaxプランの方なら1日で終わるボリュームだったと思います。
Claude Codeの威力を思い知りました。
InsightFaceを使った大量写真からの顔認識
スポーツクラブや学校等でイベントの写真を公開・共有してくれるのは大変ありがたいですが大量の写真の中から家族の写真を探し出すのは一苦労です。もちろん、家族以外の写真も見ながらイベント全体としての思い出を噛み締めるのも大事ですが。。😅
3年前にAWSのRekognitionを使って大量の写真の中から家族が写っている写真を見つけてくるツールを実装しました。
ただ、そこそこのお金がかかるので使い続けていませんでした..。 具体的には、1名分3枚の顔画像をテンプレートとして用意し、そこから1000枚のアルバムを対象に顔認識すると450円ほどかかってしまいました。
そんな中、InsightFaceというOSSを発見したので新規に顔認識ツールを実装しました。
学習済みモデルとPythonパッケージが提供されているので pip install ですぐに顔検出、顔認識を始められます。
無料で実行でき、最高です。
ただし、
ALL models are available for non-commercial research purposes only.
とあるので商用利用はできません
InsightFaceの使い方
公式ページに以下のQuick Exampleがありますが、本当に簡単です。10数行のコードで顔検出できます。
import cv2
import numpy as np
import insightface
from insightface.app import FaceAnalysis
from insightface.data import get_image as ins_get_image

app = FaceAnalysis(providers=['CUDAExecutionProvider', 'CPUExecutionProvider'])
app.prepare(ctx_id=0, det_size=(640, 640))
img = ins_get_image('t1')
faces = app.get(img)
rimg = app.draw_on(img, faces)
cv2.imwrite("./t1_output.jpg", rimg)
この例では、用意されたサンプル画像での顔検出ですが img = ins_get_image('t1') を img = cv2.imread(image_path) に置き換えれば任意の画像で顔検出できます。
顔認識用のコードサンプルも提供されているので顔認識もすぐに実装できます。
一応、上記のQuick Exampleの注意点として、app.draw_on(img, faces) の実行時に AttributeError: module 'numpy' has no attribute 'int' というエラーが出るので以下のワークアラウンドが必要です。
import numpy as np
np.int = int  # エイリアスを作る
ただし、検出した顔の枠を表示する機能を自前で実装すればこのワークアラウンドは不要です。
他に、公式以外で参考にした記事(「顔認証システムの作り方」、「【Python】InsightFaceのインストールと顔認識プログラムの作成 - ITリテラシー拡大ブログ」)では、Cythonを先にインストールせよ という記述がありましたが
pip install onnxruntime
pip install insightface
だけで特に問題ありませんでした。
運用開始してみて
1人あたり顔特徴ベクトル1個だけでは認識率が思ったより出ませんでした(もちろん閾値次第ですが)。ということで、3個以上の顔特徴ベクトルを登録して運用しています。
insightface/model_zoo at master · deepinsight/insightface · GitHub によると
InsightFaceのデフォルトではbuffalo_l というモデルパックが使われるようです。
上記のページに人種ごとの認識率のデータが記載されていますが、 East Asian は Accuracy が 74.96 ということで他の人種(African、 Caucasian、South Asian)より抜けて低く、その影響もあるかもしれません。
Amazon Rekognition に関する最近の研究論文および関連記事についての考察 | Amazon Web Services ブログ から、
AWS が Amazon Rekognition の最新バージョンを使用して実行したテストで、12,000 以上の画像で性別分類を実行するために顔分析を実行しました。6 種類の民族 (南アジア、ヒスパニック、東アジア、白人、アフリカ系アメリカ人、中東) にわたる 1,000 人の男性と 1,000 人の女性をランダムに選択しました。すべての民族で、性別分類の精度に有意差は見られませんでした。
と言っているので、人種対応(白人以外への対応)については商用の顔認識のほうに分があるようです。
でも、複数個登録しておけば満足できるレベルで認識してくれるので今のところ問題にはしていません。無料、最高です。
また、デフォルトの buffalo_l(ResNet50、326M) ではなくそれより大きいモデルパックの antelopev2 (ResNet100、407M) を使うと改善されるかもしれません。いずれ試してみたいと思います。
netkeibaデータにアクセスできるMCPサーバー作ってみる
MCP(Model Context Protocol)サーバーの記事や情報に触れない日はないっていうほど流行っているMCPに入門してみました。サンプル動かすだけもアレだしPOGドラフトの時期ということもあり、netkeibaデータを使ったMCPサーバーを作ってみました。
実装した機能
実装した機能(Tool)は以下になります。
- お気に入り馬のランキングを取得する機能

- → 期待されている馬ほどお気に入りの数も多くなっていると考えられ、ドラフト検討の材料になります。
- 指定した馬の掲示板コメントを取得する機能

人気1位の馬の掲示板 - → ポジティブなニュース、ネガティブなニュースがいろいろ集まってくると考えられ、ドラフト検討の材料になります。AIによる情報要約に期待
- 馬名とnetkeibaの馬IDを相互変換するサポート機能
MCPサーバーの作り方の練習目的なので機能は最小限に絞っていますが機能拡張して血統情報や厩舎情報などにもアクセスできると利便性高まると思います。
理想的にはリアルタイムに最新のデータ取得するべきですが、実験だし無闇にnetkeibaのサーバー負荷かけるのもよくないので予めスクレイピングしたデータを保存しておき、それを参照するような実装にしています。
あらかじめファイル保存するのであればNotebook LMで同じことできるはずですがそこは目をつぶります。。
Claude Desktopで実際に使ってみた様子
人気の馬を知る

今は実装していないですがブックマーク数の変化(例えば、人気急上昇)なども分かると良さそうです。
特定の馬の情報を集める


要約、情報整理してくれるのは期待通りに便利。
複数の馬から条件に合う馬をピックアップする

文字数制限で途中(2頭目)で打ち切られてしまいました。。
人気の馬はコメント数も多いのですがファイルサイズで約30KB、文字数で約1万文字程度。
Claudeの公式ページの情報によると、
- What is the maximum prompt length? | Anthropic Help Center
- How do I increase my usage limits? | Anthropic Help Center
「Claude Proのコンテキストウィンドウは現在20万以上のトークン(約500ページのテキストまたは100枚の画像)」、「claude.aiの無料オープンベータ版のコンテキストウィンドウとメッセージ制限は、現在の需要によって変動する場合があります」とのことなので、無料プランの壁なのでしょうか..
これが期待通りに動けばPOGドラフト検討に役に立ちそうな感触ですが今回は残念でした。Proプランであれば問題にならないことを期待しています..
あるいは、Claude DesktopではなくCline等で他のLLMを使えば問題にならないかもしれません。
また、過去全部のコメントを返しているので最新の一定数のコメントを返すなど実装面での工夫も必要かもしれません
Notebook LMでやってみる
Webから取得したコメントはファイルに書き出しているため、前述したようにNotebook LMでも同様のことが実現可能です。
試しに、ファイルを10個登録してやってみた結果が以下です。

提供されたソースには、いくつかの競走馬について、その成長の様子や関係者の期待、調教の進捗などから早期のデビューが見込まれる、あるいはデビューが心待ちにされているといった情報が含まれています。
早期デビューが見込まれる、またはデビューへの期待が高いと読み取れる馬を以下に挙げます。
スティルアイライズ (幼名: まめちゃん) 幼い頃は小さい馬体というハンデがあり、なかなか立ち上がれず心配された時期もありましたが、その後は順調に成長し、満2歳を迎えています。馴致や坂路でのトレーニングの様子が投稿されており、人を乗せての調教も始まっていることがうかがえます。ウオッカも過ごした育成場でトレーニングを頑張っているとの情報もあり、デビューが待ち望まれています。netkeibaに登録されたり、掲示板が開設されたりしたことも、デビューが近いことを示唆しています。
シーガルワールド (母: メーヴェの2023) 馬名が「シーガルワールド」に決定し、その意味は「かもめ+世界。母メーヴェ(カモメ)から連想。世界へ翔く」とされています。ノルマンディーの岡田代表からは、名前は既に決まっており、ファンの多い子なので入厩前に登録すると言及されています。これにより、デビューに向けて着実に準備が進められている様子がうかがえ、デビューが待ち遠しいという声が多く見られます。
ハムタン (母: カレンブーケドールの2023) 馬名が「ハムタン」に決定し、「ハムスターより+敬称」が由来の一つとされています。武幸四郎厩舎に入厩することが決まっており、馬体も成長して順調であるとの情報があります。血統的には早い時期からの活躍が期待されており、無事に初競馬を迎えることを多くの人が願っています。
プロメサアルムンド (母: アーモンドアイの2023) 馬名が「プロメサアルムンド」に決定し、スペイン語で「世界への約束」、母名からの連想とされています。体つきがしっかりしており、早期から坂路調教を週5日または週6日でこなすなど、順調にトレーニングを積んでいる様子が報告されています。調教の動きにパワーが感じられるとのことで、来年の2歳重賞戦線に出てきて欲しいという期待も寄せられています。
イクシード (母: イクイノックスの2023) 馬名が「イクシード」に決定したと見られます。すでに490kgを超える大きめの馬体をしており、早期デビューできそうだとコメントされています。無事に、そして元気に走って欲しいと願われています。
グランマエストロ (母: グランアレグリアの2023) 馬名が「グランマエストロ」に決定し、スペイン語で「巨匠」を意味するとされています。馬格の成長や体調面が順調であるとの情報があり、身のこなしにスピードを感じるという期待も寄せられています。順調であれば6月東京でのデビューを望む声もあり、デビューが心待ちにされています。
キタサンブラックの2023 (高額取引馬) セレクトセールにて5億9000万円(税込6億4900万円)という高額で落札された馬です。多くの人がその価格や血統、馬体から注目しており、「来年の新馬戦が楽しみ」という声や、「6月にまたお会いしましょう」というコメントがあり、早期のデビューが期待されていることがうかがえます。
コンヴェンションの2023 ツアーで得られた情報として、姉よりも筋肉量が多く、桜花賞を目標としていること、気性に問題がないことなどが挙げられています。桜花賞というクラシック路線を目標にしていることから、順調に進めば2歳のうちにデビューを迎える可能性が高いと考えられます。
これらの馬は、それぞれのソースで早期のデビューに向けた準備や期待が語られており、今後の動向が注目されています。
エージェント的な振る舞いを期待せずコメント分析だけに限るなら、こっち(Notebook LM)でも十分実用的かもしれないです😅
参考記事
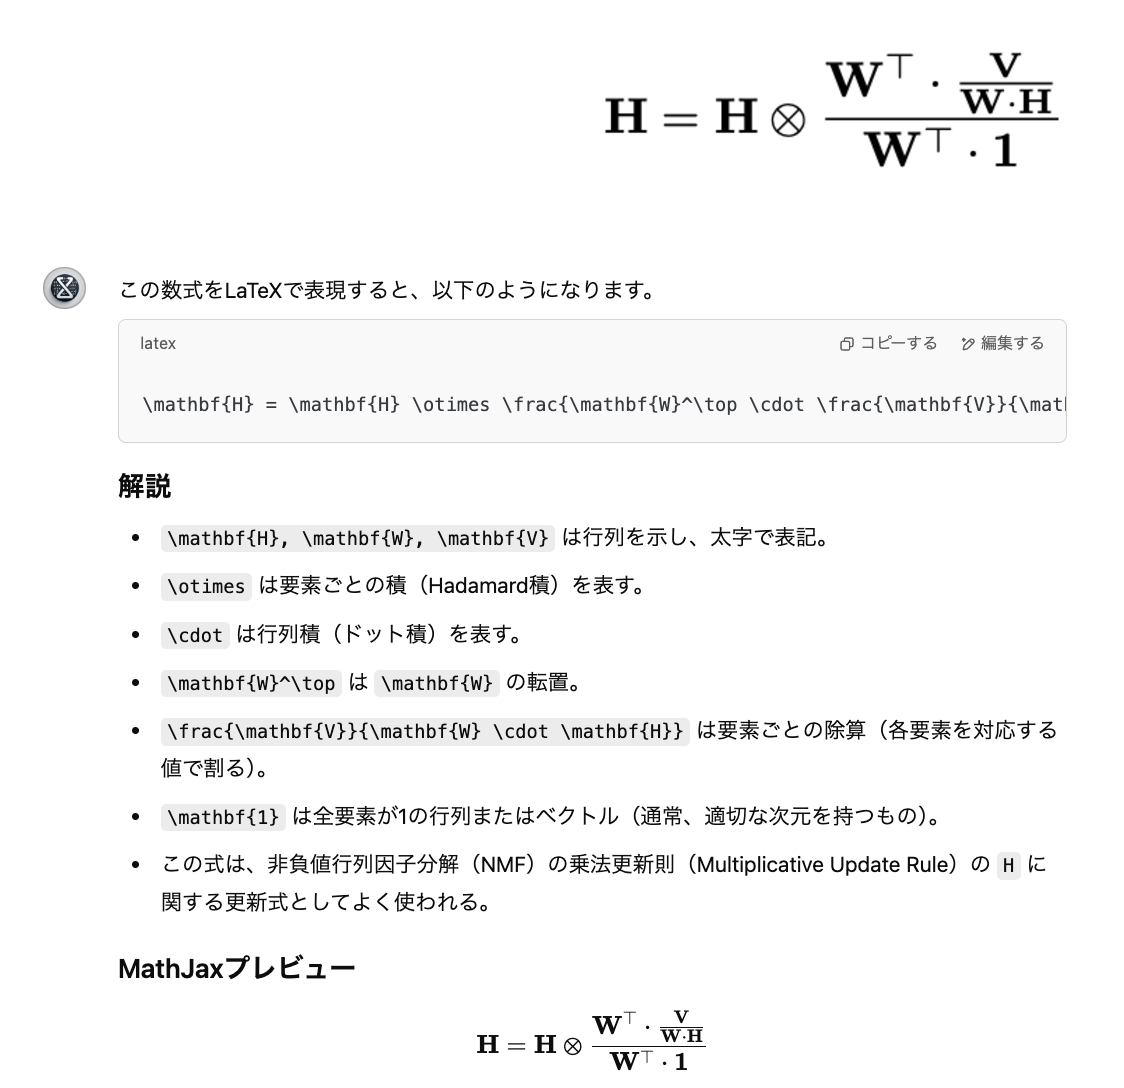
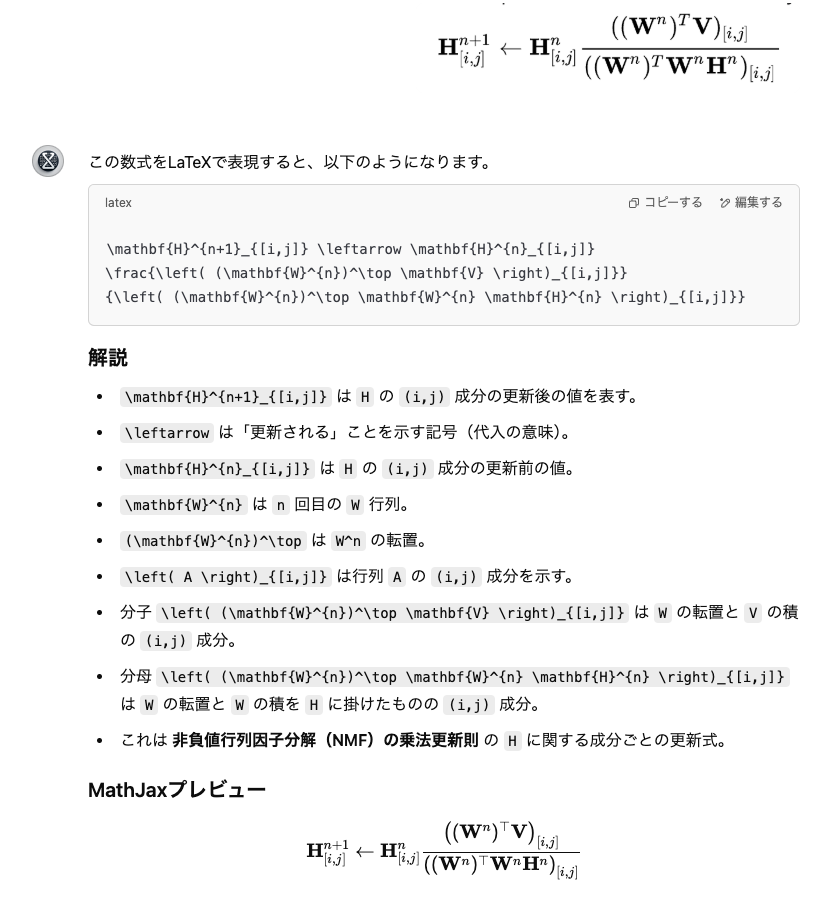
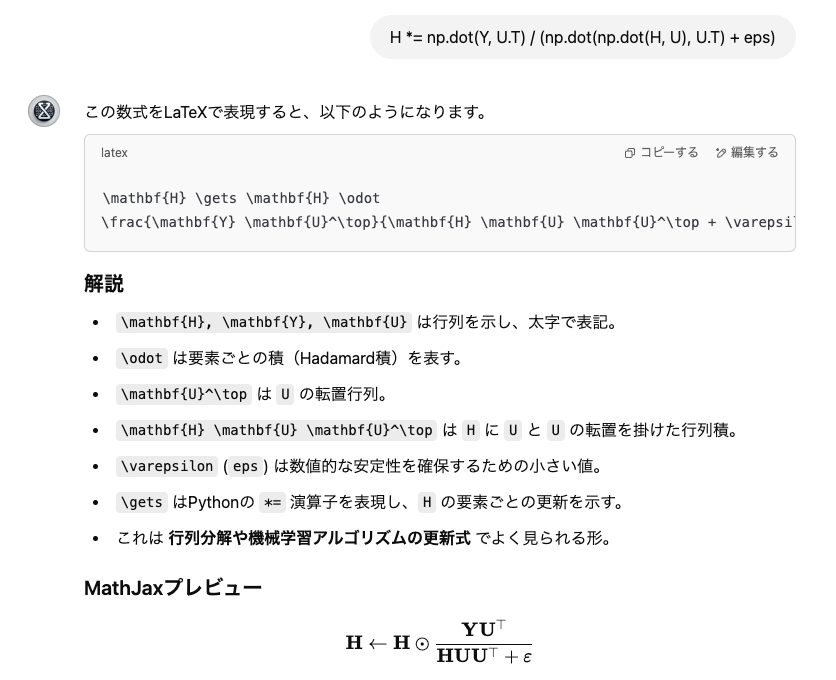
LaTex数式を出力するMyGPT
Google Colab やブログ記事で数式をLaTexで書く時にいつも調べながら試行錯誤しながら書いていてとても時間がかかっていました。しかも、すぐに忘却してしまい何度も同じことをやっている気がする...
なので、MyGPTにしてみました。
プロンプトは基本的には以下だけなので、わざわざ専用ChatBotにしなくてもよいかもしれませんが。。
プロンプト
あなたはLaTex数式表現のエキスパートです。
受け取った数式データをLaTexで出力してください

### 受け取るデータ
- 数式を含む画像やテキスト
- 数式を表現するコード

### 出力するもの
- LaTex数式の文字列 (コピーできるようにすること)
- LaTex数式の解説

解説のあとにMathJaxでのプレビュー結果も表示すること
数式のスクリーンショット画像や数式のPythonコードを受け取って LaTex表現を返します。
出力例
例6はPythonコードを入力し、例6以外はスクリーンショット画像を入力しています。
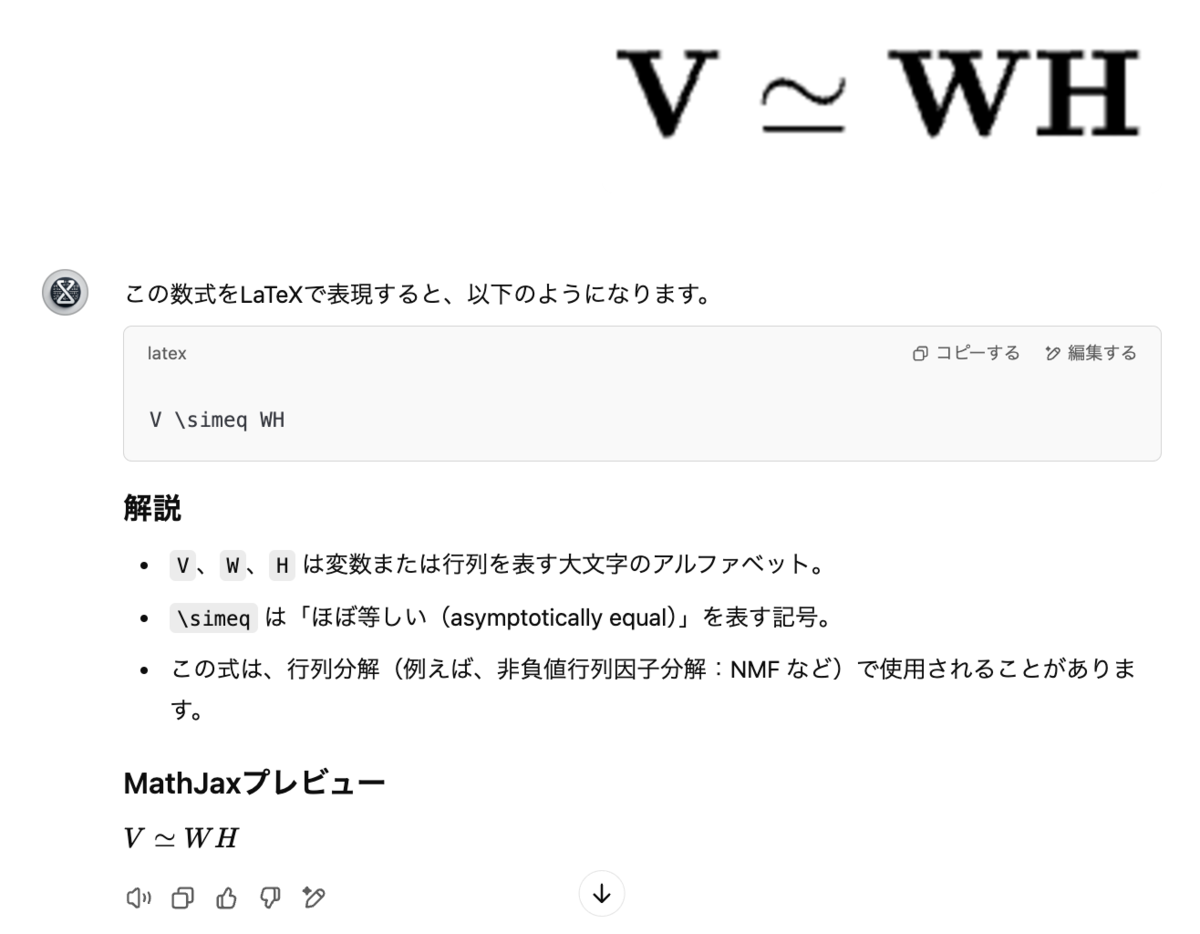
例1
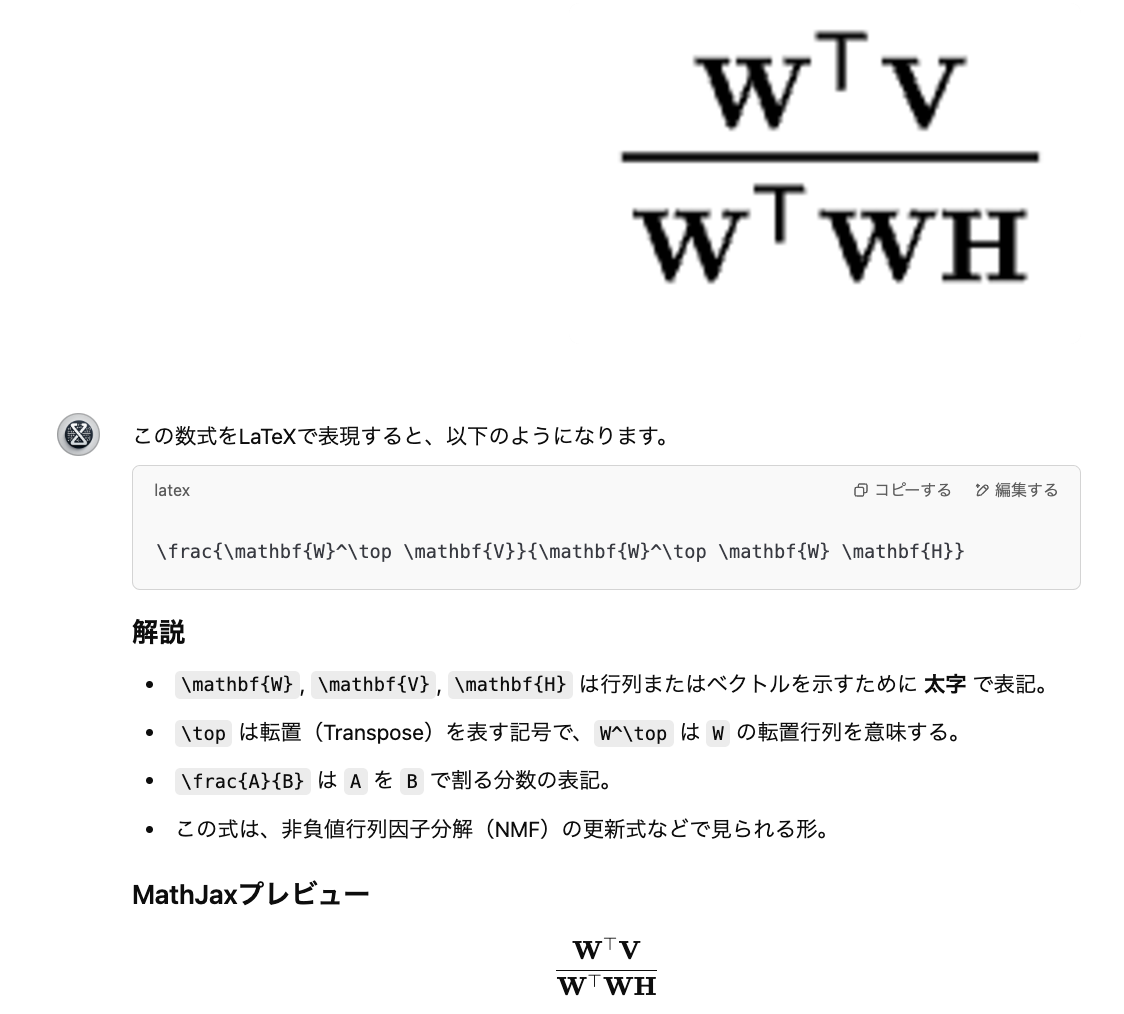
例2
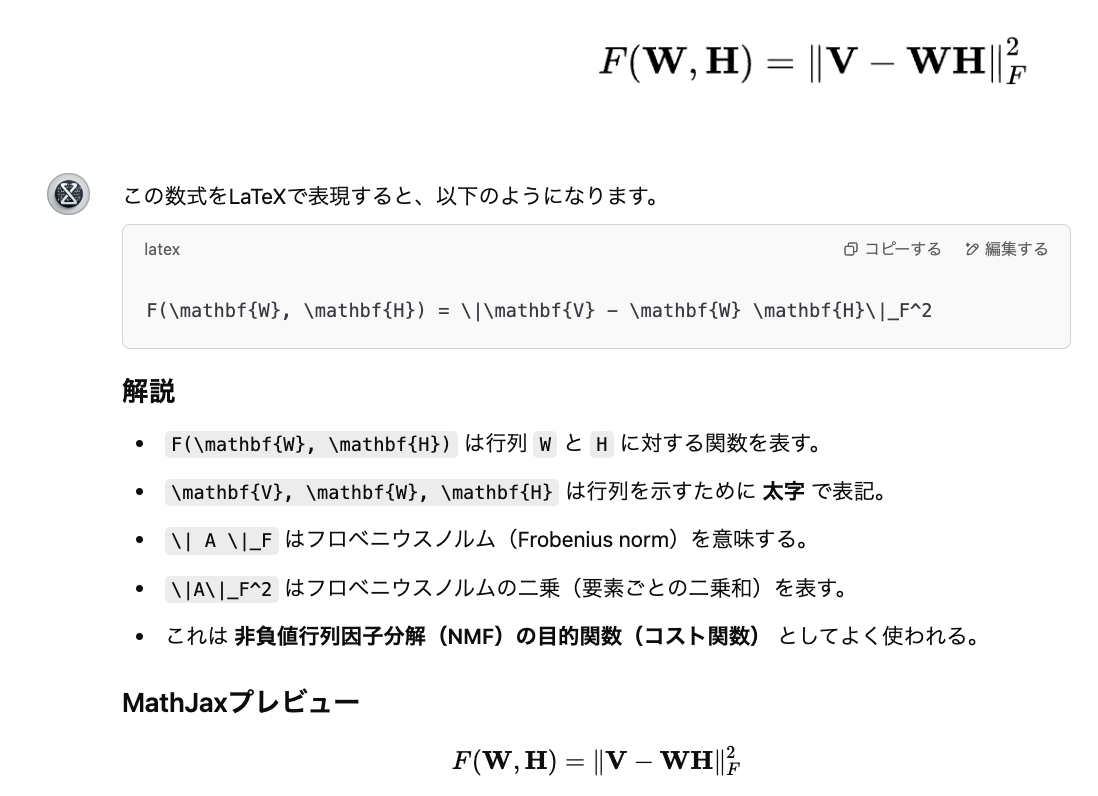
例3
例4
例5
例6
作ってみて
もっと複雑な式を色々と試す必要がありますがとりあえず期待した通りには動いてくれました。完璧にいかない場合もあるかもしれませんがそれでも時短にはなるでしょう
プロンプトを毎回コピペするのも面倒なのでBotにして良かったかなと思ってます
NMFの定式表現で混乱した件
NMF(Non-negative Matrix Factorization)の定式化は、元祖?の論文であったりWikipediaであったり
$ V = WH $
と表されます。
図で示すと
 (Wikipediaページより)
となります。
ここで、それぞれの行列の次元は
- V: (n_features, n_samples) ← 入力データ
- W: (n_features, n_components) ← 基底行列
- H: (n_components, n_samples) ← 係数行列
となっています。 $ n\_components \ll n\_features $ であり、少ない要素数で元データであるVを表現できます。
W は 基底行列、 H は 係数行列 と呼ばれます。
scikit-learnのNMFメソッド
ところが、scikit-learnでは 定式表現は $ X = WH $ と、論文と同じ形式ですが
各行列の意味は
- X: (n_samples, n_features)
- W : (n_samples, n_components) ←係数行列
- H: (n_components, n_features) ←基底行列
となっており、WとHに関して、意味するものが逆になっているのです。
コードでは、
W = model.fit_transform(X)
H = model.components_
です。
scikit-learnでは LinearRegressionやらRandomForestやらfit(X, y) の X は (n_samples, n_features) なのでそれに合わせたインタフェースになっているのですがわかりにくい..
X = HW と表現してくれればよいのになぁ
アルファベットの由来
ChatGPTにより由来を調べてみると
W
W は、行列の「Weights(重み)」や「Basis(基底)」を示すことが一般化しています。
H
H は、データ Y を基底 W を用いて近似するときの係数(または重み)を示します。この係数行列は、元のデータの「隠れた構造(Hidden Structure)」を表現していると考えられます。
「Hidden」の頭文字である H を採用した可能性が高いです。
H は 各サンプルのデータを潜在表現していると言えるので なるほど と思いました。
他の論文や学会資料・講義資料での数式表現
ちなみに、他の論文や学会誌でのNMFの数式表現は以下のようになってました。
- Non-negative Matrix Factor Deconvolution; Extraction of Multiple Sound Sources from Monophonic Inputs
- 定式化: V = WH
- V: 基底行列、H: 係数行列
- 定式化: V = WH
- Semi-Supervised Nonnegative Matrix Factorization
- 定式化 :X = AS
- A: 基底行列、S: 係数行列
- 定式化 :X = AS
- 非負値行列因子分解
- 定式化 : Y = HU
- H: 基底行列、U: 係数行列
- 定式化 : Y = HU
- 非負値行列因子分解 NMF の基礎と データ/信号解析への応用
- 定式化 :X = TV
- T: 基底行列、V: 係数行列
- 定式化 :X = TV
V = WHが主流だとは思うのですがなんかバラバラですね..
Uは基底行列を表すことが多いことから考えると 亀岡先生の Y = HU は微妙...
論文からのタイトル抽出、Abstract抽出をLLMで置き換える
約3年前になりますが過去の記事「ミニマルな論文管理ツールを作る - sanshonokiの日記」において論文からタイトル抽出やAbstract抽出することをやっていました。
当時はChatGPT(2022年11月発表)も存在してなく、ルールベースのアルゴリズムで実装しました。
記事中にも書いていますがいくつかの論文では特殊なルールを追加して対応しなければいけませんでした。その結果、アルゴリズムも若干複雑化してしまいました。
今回、LLMを使うことによりその課題が解決されているか確認してみました。
結論から言うと、期待通りに動作し、また、ルールベースでは抽出しづらいKeywordsもそれっぽく抽出してくれました。
また、コストはGPT-4o miniを使って1論文あたり約0.0235円でした。
LLMでの処理
コードは基本的にこれだけです。LLMのモデルはGPT-4o-miniを使いました。 著者リストやKeywordも追加で抽出するようにしています。
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from pydantic import BaseModel, Field
import pypdf


class Paper(BaseModel):
    title: str = Field(description="Paper title")
    authors: list[str] = Field(description="Paper authors")
    abstract: str = Field(description="Paper abstract")
    keywords: list[str] = Field(description="Paper keywords")


def extract_paper_info(filepath, num_of_pages=1):
  reader = pypdf.PdfReader(filepath)
  content = ""

  for i in range(num_of_pages):
    content += reader.pages[i].extract_text()

  prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "論文のタイトルと著者と概要とキーワードを抜き出してください"),
        ("human", "{content}"),
    ]
  )

  model = ChatOpenAI(model="gpt-4o-mini")
  chain = prompt | model.with_structured_output(Paper)
  paper_info = chain.invoke({"content": content})
  return paper_info
Abstractは原則1ページ目に含まれるので1ページ目のテキストだけを使って、無駄なトークンを消費しないようにしています。
まれに1ページに大きな図が入っていたりしてAbstractが2ページに書かれている論文もあるのでその時はエッジケース対応が必要です。
結果
過去の記事 において取り上げた4個の論文について
| ファイル名 | 課題 |
|---|---|
| Dyna-BOLT_final.pdf | 著者に上付き文字があると見た目の高さ以上のheightになっていて、そこがTitle行として判定されてしまう |
| 1611.03530v2.pdf | 複数行に渡るタイトルで 各行のheightの高さが揃ってなく、タイトルとしてまとめられない |
| 1812.02849v2.pdf | Abstractの単語がない |
| 2102.10772v1.pdf | 2カラム形式になっていて、Abstract行の直後にIntroductionが来るのでAbstractブロックを正しく抽出できない |
Title抽出の結果
| ファイル名 | タイトル(正解) | タイトル(出力) |
|---|---|---|
| Dyna-BOLT_final.pdf | DYNA-BOLT: DOMAIN ADAPTIVE BINARY FACTORIZATION OF CURRENT WAVEFORMS FOR ENERGY DISAGGREGATION | DYNA-BOLT: DOMAIN ADAPTIVE BINARY FACTORIZATION OF CURRENT WAVEFORMS FOR ENERGY DISAGGREGATION |
| 1611.03530v2.pdf | UNDERSTANDING DEEP LEARNING REQUIRES RE- THINKING GENERALIZATION | UNDERSTANDING DEEP LEARNING REQUIRES RE - THINKING GENERALIZATION |
Abstract抽出の結果
| ファイル名 | Abstract(正解) | Abstract(出力) |
|---|---|---|
| 1812.02849v2.pdf | Deep learning has produced ~ and open research directions. | Deep learning has produced ~ and open research directions. |
| 2102.10772v1.pdf | We propose UniT, a Unified Transformer model ~ Code will be released in MMF at https://mmf.sh. | We propose UniT, a Unified Transformer model ~ Code will be released in MMF at https://mmf.sh. |
完璧でした。個別対応もなくなり素敵です。Authorsも正確に抽出できておりKeywordsもIndex Termsとして正解がある論文では正確に抽出していました。他の論文でも違和感ない内容で出力されていました。
コスト試算
手元にある589個の論文の1ページ目の平均トークン数は 2161 でした。
- GPT-4o-minの価格: $0.150/1M 入力トークン
- 為替レート:1$ = ¥156.46
から試算すると
1論文あたり $0.00015 (¥0.02348)となります。
タダではないですがこの出費だったら問題にならないレベルかなと思います。
やってみて
手持ちのすべての論文について確認できていませんが大量に学習されている構造化された文書ではLLMが得意ですね。
逆を言えば、非構造化された文書ではどこにLLMを適用するかを十分に検討しなければらないといけなそうです。ハルシネーション対策、精度を上げるため複数プロンプトに分割することによるコスト増加対策etc
